
Usted no compró el más barato. Compró otro sistema.
Diez decisiones de ingeniería separan las dos propuestas, ninguna de ellas escrita en la cotización, y al final hay una cuenta que dice cuánto más barata tiene que ser la más barata para empatar
- Dos propuestas para la misma carga, con la misma capacidad sobre el papel, pueden ser dos sistemas distintos. La diferencia no está en el precio: está en diez decisiones que la cotización no escribe.
- El depreciation schedule y la vida útil son dos relojes distintos sobre el mismo activo. Uno es cómo usted recupera el costo contra el impuesto; el otro es por cuánto tiempo el sistema todavía vale la pena. La compra sólida alinea los dos.
- Con la carga limitada por ancho de banda de memoria, el sistema especificado en el piso entrega el 69% del caudal. Tiene que ser un 31% más barato solo para empatar, antes de electricidad, cambio de disco y la actualización que se vuelve recompra.
- Un hiperescalador extendió la vida de sus servidores de cinco a seis años, registró US$ 2.500 millones de utilidad neta, y en doce meses tomó parte de vuelta citando el ritmo de la inteligencia artificial.
- El líder del Green500 pasó de 15,1 a 73,3 GFLOPS por vatio entre 2019 y 2026. Un sistema en la frontera antigua necesita casi cinco veces la electricidad para el mismo trabajo, y es la cuenta de luz la que jubila una instalación de HPC, no la falla.
- Un disco de 3,84 TB a 1 DWPD cierra en 3,2 años bajo 6 TB de escritura por día. El mismo disco a 3 DWPD atraviesa los cinco. La cotización dice la capacidad, no dice la clase.
La pregunta de negocio
Quien decide por precio no está equivocado sobre el precio. Está equivocado sobre qué es lo que el precio está midiendo.
Dos propuestas para la misma carga. Mismo acelerador, misma cantidad, misma capacidad sobre el papel. Una es bastante más barata, y la única palabra disponible para explicar la diferencia al directorio es “precio”.
La respuesta, antes del argumento. Con la carga limitada por ancho de banda de memoria, el sistema especificado en el piso entrega el 69% del caudal del otro. Para el mismo trabajo hacen falta 1,45 de él. Por lo tanto la propuesta más barata tiene que ser un 31% más barata solo para empatar, y eso antes de electricidad, cambio de disco y la actualización que se vuelve recompra. Si la capacidad se alcanza poblando la mitad de los canales, el descuento necesario sube al 62%.
Ese número descansa sobre premisas, y todas están declaradas y son reemplazables por las suyas en la última sección. Lo que existe entre aquí y allá son diez decisiones de ingeniería que nadie escribe en la cotización, y que deciden por cuántos años el sistema sigue siendo el sistema que se compró.
Hay dos maneras de llegar a una propuesta de sistema. La primera parte del catálogo: se toma lo que está disponible, lo que es compatible, lo que cierra el precio, y se arma. La segunda parte de la aplicación: se mide la carga, se declara el horizonte, y cada pieza se elige para sobrevivirlo. Las dos entregan algo que enciende el primer día. Solo una de ellas responde por cuánto tiempo.
La primera es más barata, y tiene que serlo. Está vendiendo menos sistema.
Y lo que está en juego aquí es un solo vértice. Las diez decisiones de este texto viven enteras dentro del cómputo: el nodo que procesa. Un sistema de computación acelerada tiene además la energía que lo alimenta, el circuito térmico que lo mantiene dentro del envolvente, la red que une los nodos entre sí, el almacenamiento que los abastece, y la capa de sistema operativo y aplicación que decide si todo el resto se vuelve ciencia. Cada uno de esos carga su propia lista de decisiones que nadie escribe. Si un vértice esconde diez, la pregunta que importa es cuántas esconden los otros cinco.
Cuadro · las diez decisiones y lo que cada una acorta
| # | Decisión | Medida en | A qué renuncia usted |
|---|---|---|---|
| 1 | Horizonte asumido | años en el schedule, trabajo por vatio en el campo | Un schedule de cinco años contra un ciclo de 18 a 36 meses, y casi 5× la electricidad para el mismo trabajo |
| 2 | Generación del procesador | canales de memoria × tasa DDR5 | 461 contra 614 GB/s por zócalo, entre dos generaciones consecutivas |
| 3 | SKU de zócalo único | sufijo del fabricante (P, U) | La expansión. El camino documentado pasa a ser sustitución |
| 4 | Módulos por canal | DPC y la caída de MT/s | 31% del ancho de banda a 2DPC, o 62% si la mitad de los canales queda vacía |
| 5 | Clase de endurance | DWPD y TBW | Un cambio dentro del schedule: 3,2 años contra 5 |
| 6 | Clase de la fuente | eficiencia certificada por punto de carga | Cerca de US$ 22 mil de electricidad por rack en cinco años |
| 7 | Envolvente térmico y chasis | °C en la entrada, caudal a través de la placa | La garantía, cuando la telemetría muestra el envolvente excedido |
| 8 | Lane budget | lanes, GB/s, ns de latencia | 32 lanes para toda la red y todo el almacenamiento |
| 9 | Generación del enlace, en ambos extremos | generación PCIe del slot y del dispositivo | La mitad del ancho de banda con el mismo ancho en lanes |
| 10 | Apertura de la arquitectura | conformidad con una definición publicada | El precio de mercado de toda pieza agregada después del año uno |
Arraste para o lado para ver a tabela inteira.
Lo que el cuadro esconde. Las diez no son independientes. La 2, la 8 y la 9 son la misma compra vista tres veces. La 10 multiplica lo que todas las demás cuesten arreglar después. Sumar las diez ingenuamente exagera; la última sección muestra cómo sumar.
La disciplina detrás de esto
Nada aquí es invención y nada es gusto. Las diez decisiones pertenecen a una disciplina de ingeniería con norma, método y aritmética propia, practicada donde un sistema tiene que estar disponible y no meramente entregado.
Tiene nombre, RAMS, de confiabilidad, disponibilidad, mantenibilidad y seguridad. Tiene método para resolver un sistema compuesto en caminos, el diagrama de bloques de confiabilidad, que dispone el sistema en elementos en paralelo y en serie: fuentes redundantes en paralelo, el fabric en serie, la capa de almacenamiento en serie. Serie es el arreglo implacable, porque una cadena en serie solo está tan disponible como su eslabón más débil, y el eslabón más débil rara vez es el componente que aparece en la propuesta.
Y tiene una ecuación que decide más de lo que se espera:
Disponibilidad  =  MTBF / (MTBF + MTTR)

  MTBF   tiempo medio entre fallas.   Propiedad del hardware.
  MTTR   tiempo medio de reparación.  Propiedad del contrato.
El segundo término es el que suele quedar sin especificar, y es el que domina. Con un MTBF de sistema de 67 horas, que es una entrada medida en su propia flota y no un número publicado aquí:
  MTTR  4 h   atención en campo         A = 94,4%     494 h/año   ≈ 21 días
  MTTR  8 h   siguiente día hábil       A = 89,3%     934 h/año   ≈ 39 días
Mismo hardware, misma tasa de falla, mismo todo lo que la cotización describe. Dieciocho días de producción al año separan a los dos, y la diferencia nunca fue especificación de equipo.
Es la lección que corre por debajo de las diez decisiones que vienen a continuación: un MTBF alto no rescata un MTTR malo, y la disponibilidad no es un componente que se compre. Es propiedad de la cadena entera, calculada y no presumida.
1 · Dos relojes, y la cotización no nombra ninguno
Toda propuesta asume un número de años. Casi nunca está escrito, y casi siempre es de tres a cinco. Ese número está haciendo el trabajo de dos, y no son el mismo número.
El primer reloj es el depreciation schedule. Es instrumento contable. Reparte el precio de compra a lo largo de un número de años y reduce la utilidad gravable en cada uno de ellos, es decir, es un crédito contra el impuesto. La práctica tributaria estadounidense clasifica computadora, servidor y equipo de red como propiedad de cinco años. La política patrimonial interna de un organismo federal usa siete para sistemas por encima de un umbral de valor. Las dos son fuentes institucionales de igual peso y discrepan, porque describen universos distintos. Ninguna de las dos mide cuánto dura el hardware, y eso no es un defecto de ellas: medir hardware no es lo que hace un depreciation schedule.
El segundo reloj es la vida útil. Es un hecho de ingeniería y de operación: por cuánto tiempo el sistema sigue produciendo trabajo útil a un costo que todavía justifica mantenerlo encendido. La física gobierna parte de eso, por endurance y envolvente térmico, y la economía gobierna el resto, principalmente la energía que cuesta comprar una unidad de trabajo.
Confundir los dos es donde se va el dinero. El schedule dice cómo usted recupera el costo del activo en el papel y contra el impuesto. La vida útil dice cómo recupera la inversión de hecho, en trabajo producido. Los dos no compiten, y el punto no es elegir entre ellos. El punto es comprar un sistema cuya vida útil sea al menos tan larga como el schedule contra el cual se lo está depreciando, y luego operarlo todo ese tiempo. Esa es la cara de una inversión bien hecha en un parque computacional: el beneficio fiscal aprovechado por entero, y el sistema todavía produciendo mientras usted lo aprovecha.
El modo de falla es el desajuste. Un sistema que queda económicamente obsoleto años antes de que el schedule cierre deja al área financiera todavía deduciendo depreciation sobre un equipo cuya cuenta de luz ya cuesta más que el trabajo que devuelve. El activo está en el book; el valor no está en la sala.
Y el horizonte se mueve, en público, con cifra. Un operador de hiperescala declara en su formulario anual que extendió la vida útil de sus servidores de cinco a seis años en enero de 2024, reduciendo el gasto de depreciation en US$ 3.200 millones y sumando US$ 2.500 millones a la utilidad neta del año. Doce meses después, el mismo documento registra la vuelta: estudio de vida útil concluido en el cuarto trimestre de 2024 y la vida de un subconjunto de servidores recortada de seis a cinco años, a un costo previsto de US$ 700 millones de resultado operativo. En el mismo trimestre decidió jubilar servidores antes y registró US$ 920 millones de depreciation acelerada.
El documento da el motivo en una frase:
These two changes above are due to an increased pace of technology development, particularly in the area of artificial intelligence and machine learning.
Léalo como los dos relojes: el reloj contable fue reajustado para perseguir al de ingeniería, y reajustado otra vez cuando el de ingeniería avanzó más rápido de lo esperado. Quien tiene más visibilidad sobre el envejecimiento de hardware que cualquier comprador de un clúster extendió el horizonte, registró dos mil quinientos millones de utilidad, y en un año devolvió parte. El horizonte no es un hecho sobre el equipo. Es una estimación, se la revisa, y la revisión tiene precio.
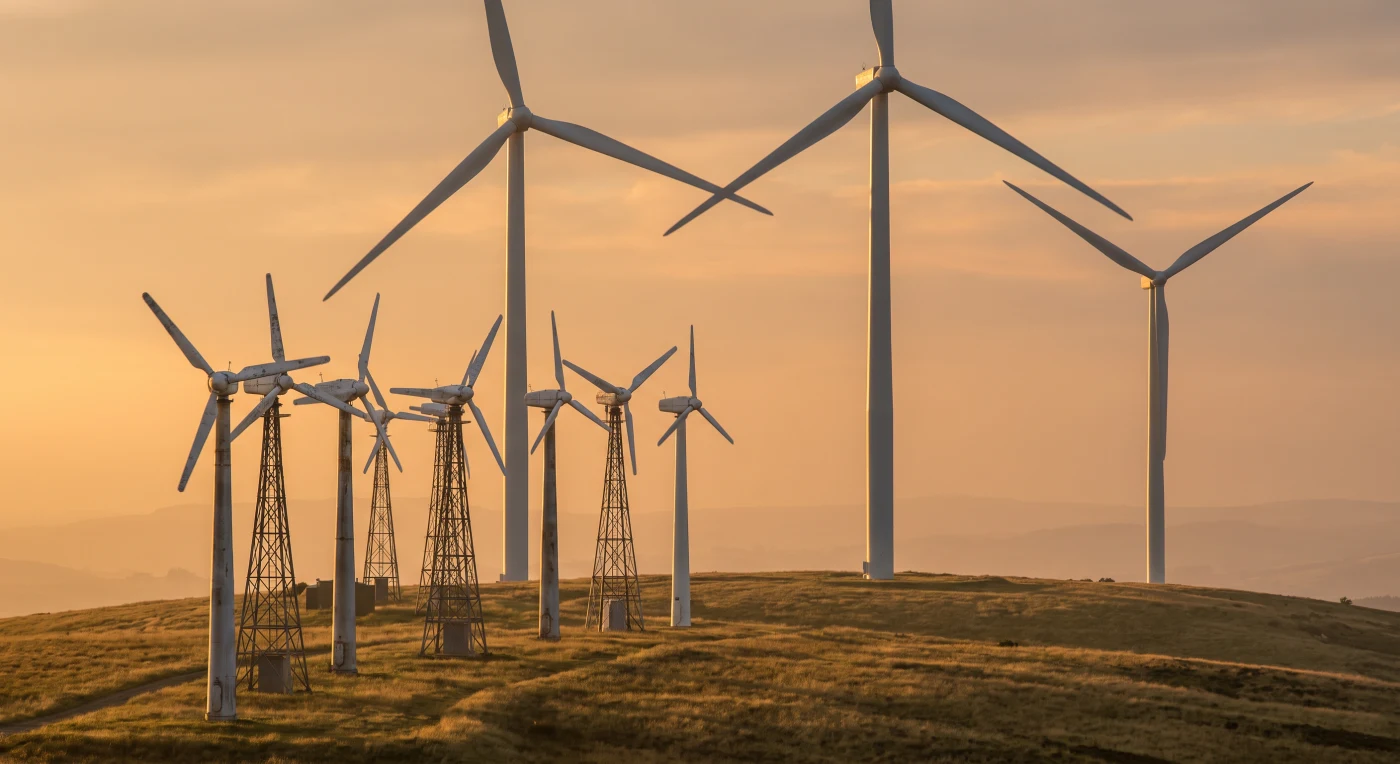
El reloj de la vida útil es el que de hecho jubila instalaciones. Un sistema no deja de funcionar; deja de valer la pena. La medida es trabajo por unidad de energía, y se mueve lo bastante rápido como para aparecer en un ranking público: el líder del Green500 pasó de 15,1 GFLOPS por vatio en junio de 2019 a 73,3 en junio de 2026.
El mismo trabajo, en dos fronteras de eficiencia

  sistema en la frontera de 2019   necesita  ≈ 4,8 ×  la electricidad
  sistema en la frontera de 2026   necesita      1 ×

  La cuenta mensual de energía no baja cuando el sistema envejece.
  El trabajo que compra, sí.
Por eso se jubilan instalaciones de HPC que funcionan. El hardware no falló. La misma cuenta de luz pasó a comprar una fracción de lo que el mismo presupuesto compra en un sistema actual, y en algún momento la diferencia financia el reemplazo sola. Un depreciation schedule no ve esto, porque mide el activo y no la electricidad.
En la práctica: pida a cada cotización que declare el horizonte y diga de dónde sacó el número. Un sistema dimensionado contra un schedule de cinco años y una carga con ciclo de tres son dos compras distintas con la misma tapa.
2 · La generación que usted hereda
Generación de servidor no es etiqueta de marketing. Es cuenta fija de canales de memoria, techo de tasa DDR5 y lane budget, y los tres se publican por generación.
Dentro de una familia corriente, la generación anterior ofrece doce canales DDR5 a 4800 MT/s y la actual mantiene doce canales elevando la tasa a 6400, con la misma cuenta de lanes PCIe 5.0. Dos generaciones atrás eran ocho canales DDR4. Canales y tasa son los dos números que fijan el ancho de banda agregado, y ninguno de los dos cambia después de la compra.
En la práctica: un zócalo de generación anterior no es un descuento en la CPU. Es techo permanente de ancho de banda de memoria para toda carga que el sistema llegue a correr, y la inferencia limitada por memoria lo siente primero.
3 · Un zócalo, y la expansión que no es una
Las dos familias corrientes publican designación oficial de SKU que restringe el procesador a configuración de zócalo único. Una usa sufijo P, la otra U, documentado por el fabricante como soportado solo en configuración de un zócalo.
La nomenclatura no es perfectamente consistente: el propio fabricante nota que algunos SKU optimizados por carga también son de zócalo único sin llevar el sufijo. El número de parte decide, no la letra.
El camino documentado de un zócalo a dos es remoción y sustitución del procesador por un par emparejado, no el agregado de una segunda unidad.
En la práctica: un SKU de zócalo único convierte una expansión futura en una sustitución futura. Es elección legítima y muchas veces la correcta. No es silencio legítimo en una cotización.
4 · Capacidad no es ancho de banda
Dos sistemas pueden cargar la misma memoria total y entregar anchos de banda distintos, porque el ancho de banda viene de canales y tasa, no de gigabytes.
Un canal de memoria es un camino entre procesador y memoria, y la placa ofrece un número fijo de ellos. Cada canal tiene uno o dos zócalos. Llenar los dos se llama 2DPC, dos módulos por canal; llenar uno es 1DPC. Llegar a la capacidad a 2DPC obliga a la plataforma a reducir la tasa, medida en MT/s, megatransferencias por segundo.
En una placa de doce canales y veinticuatro zócalos, con ancho de banda agregado calculado como canales × tasa × ocho bytes:
Configuración                           Capacidad    Ancho de banda agregado

  12 × 64 GB    1DPC   6400 MT/s          768 GB        614 GB/s
  24 × 32 GB    2DPC   4400 MT/s          768 GB        422 GB/s     69%
   6 × 128 GB   1DPC   4800 MT/s          768 GB        230 GB/s     38%
  (la mitad de los canales poblada)
La tercera es la que duele, y es hacia la que corre una cotización guiada por capacidad, porque módulo más grande en menor número se arma más barato. Menos del 40% del ancho de banda, por la vida del sistema, y la cotización dice 768 GB en las tres.
En la práctica: compare cotizaciones por canales poblados y tasa sostenida, nunca por gigabytes instalados. Dos configuraciones que dicen la misma capacidad pueden diferir por un factor de dos y medio.
5 · Endurance, o el disco que cierra antes que el schedule
NVMe es la interfaz por la cual el almacenamiento habla con el procesador, y no dice nada sobre cuánto dura el flash. Eso es especificación separada y normativa. DWPD, escrituras de disco por día, es cuántas veces el disco entero puede sobrescribirse por día durante la garantía. TBW, terabytes escritos, es el mismo hecho como total. Los dos están definidos bajo norma JEDEC.
Las cargas de referencia difieren por clase, y la diferencia es el punto. La clase cliente se mide a 40 °C, ocho horas por día. La clase empresarial, a 55 °C, veinticuatro horas por día, con distribución mixta de escritura y tasa de error más estricta. Un disco calificado contra la primera no es el mismo producto que uno calificado contra la segunda, diga lo que diga la etiqueta de capacidad.
Un ejemplo trabajado, con el volumen de escritura declarado como entrada porque no existe número publicado para él. Disco de 3,84 TB y un pipeline de checkpoint escribiendo 6 TB por día:
Clase      Escritura garantizada         Vida a 6 TB/día      Contra un schedule de 5 años

  1 DWPD      7.008 TB  (1×3,84×365×5)     1.168 d  ≈ 3,2 a    un cambio dentro
  3 DWPD     21.024 TB  (3×3,84×365×5)     3.504 d  ≈ 9,6 a    lo atraviesa por 4,6 a
Misma capacidad, mismo formato, misma interfaz. Uno de los dos tiene que comprarse dos veces dentro del horizonte que la cotización asume, y la cotización no dice cuál.
En la práctica: endurance es el único número de la cotización que puede vencer antes de que el depreciation schedule cierre. Pida DWPD y plazo de garantía, y corra la división de arriba contra su volumen medido.
6 · La fuente que cobra por hora
La eficiencia de fuente está certificada por 80 PLUS, que mide cuánto de la corriente alterna tomada de la pared llega al equipo como corriente continua útil, y publica el resultado como umbrales en puntos fijos de carga. El resto es calor.
Al 50% de carga, donde la curva alcanza su pico en todas las clases, Gold exige 90% y Titanium exige 94%. Al 20% de carga, 87 y 92. A plena carga, 87 y 90.
Dos cosas siguen. La diferencia entre clases no es constante: cuatro puntos en el pico y cinco puntos al 20%. Y la eficiencia cae en los dos extremos de la curva, así que una fuente sobredimensionada para el nodo opera permanentemente del lado ineficiente.
Esto conversa con la redundancia. N+1 agrega una unidad de reserva compartida; 2N duplica la alimentación entera, cada lado dimensionado para cargar todo por sí solo. Bajo 2N cada unidad opera con la mitad de la carga que tendría bajo N+1, es decir, la redundancia que protege la disponibilidad empuja el punto de operación hacia donde la diferencia entre clases es mayor.
La cuenta es directa, y es la misma estructura para cualquier rack:
Un rack de 75 kW de carga de TI, fuentes al 50% de carga, cinco años
Tarifa comercial promedio de EE. UU.: 14,19 ¢/kWh (EIA, junio de 2026)

  Gold        90%     75 / 0,90  =  83,3 kW tomados de la pared
  Titanium    94%     75 / 0,94  =  79,8 kW tomados de la pared
                                     3,5 kW de diferencia permanente

  3,5 kW × 8.760 h × 5 años  =  155 mil kWh
  × US$ 0,1419               =  US$ 22 mil por rack
En la práctica: clase de fuente no es ítem de cotización, es tarifa. Cambie su carga y su tarifa; la estructura de la cuenta no cambia, y su signo nunca cambia.
7 · El envolvente térmico, medido en la entrada, y el chasis que no enfría
El envolvente está normado. ASHRAE, entidad de ingeniería cuyas directrices térmicas orientan el diseño de datacenter, define un rango recomendado de entrada de 18 a 27 °C para todas las clases, con rangos permitidos que se ensanchan por clase hasta 45 °C. El punto de medición es la entrada del equipo, no el promedio de la sala, y esa distinción resuelve discusiones.
Hay una segunda decisión térmica, y es sobre el chasis, no sobre la sala. Los aceleradores de datacenter suelen ser pasivos: la placa trae disipador y ninguna ventilador propio, porque fue diseñada para un chasis que empuja aire a través de esas aletas con presión estática alta. En esas placas la refrigeración es propiedad del sistema, y la placa no tiene manera de compensar un chasis que no la entrega.
El requisito está publicado y no es modesto. Una guía de diseño de datacenter especifica un mínimo de 157 pies cúbicos por minuto de caudal por kilovatio de carga, y el sistema de ocho aceleradores del mismo fabricante pide 1.105 CFM de frente hacia atrás con los ventiladores al ochenta por ciento.
Los límites de la placa también están publicados: calificación térmica de 87 °C en el procesador y 95 °C en las pilas de memoria, con reducción de reloj por hardware disparada dos grados por debajo del límite y apagado a cinco. La documentación de gestión del fabricante nombra los dos mecanismos y describe el de hardware como reduciendo el reloj “por un factor de 2 o más”.
Un chasis no diseñado para entregar ese caudal mueve aire por encima de la placa, y no a través de ella. La placa estrangula primero, lo que parece problema de desempeño y es la protección funcionando, y degrada después, lo que parece defecto.
En la práctica: dos preguntas, no una. A qué temperatura de entrada fue validada la densidad cotizada, y por quién. Y si el chasis fue diseñado para enfriar placa pasiva a esa potencia, con número de caudal y presión estática, no con garantía verbal.
8 · Las lanes que se acaban
Una plataforma de dos zócalos en la generación corriente ofrece hasta 160 lanes PCIe 5.0. Ocho aceleradores a dieciséis lanes cada uno consumen 128. Sobran 32 para todo lo demás: toda la red, todo el almacenamiento NVMe, toda la gestión.
Un adaptador de 400 Gb/s se lleva dieciséis. Cada disco NVMe se lleva cuatro. El lane budget cierra antes de que cierre una configuración empresarial de red y almacenamiento.
Cuando cierra, la respuesta es un switch PCIe: silicio que multiplica puertos aguas abajo a partir de un número fijo de lanes de host, con latencia de paso por debajo de 115 nanosegundos en una pieza corriente. El costo no es uniforme: mediciones del propio fabricante muestran latencia variando con el tamaño del paquete y con la combinación de anchos de puerto, de cerca de 138 a 314 nanosegundos. Despreciable en transferencia secuencial grande, material en transacción pequeña y frecuente, que es exactamente el patrón de la comunicación colectiva.
En la práctica: un switch no es defecto, es respuesta de ingeniería con costo declarado. El defecto es la cotización que no dice que está ahí.
9 · La generación del slot no es la generación de la pieza
Dos sistemas pueden decir PCIe 5.0 y ninguno estar equivocado, porque la frase describe el slot y no dice nada sobre lo que está enchufado en él. Las tasas las publica el consorcio de norma: 8 GT/s en la generación 3, 16 en la 4, 32 en la 5, 64 en la 6, una duplicación en cada paso.
Plataforma por debajo del acelerador. Un procesador de generación anterior trae el root complex de generación anterior consigo, y el fabricante documenta la consecuencia sin editorializar: el resumen de producto de un acelerador corriente lista los modos de interfaz soportados como Gen5 x16, Gen5 x8 o Gen4 x16, tres modos presentados como equivalentes. Es el fabricante diciendo, en una tabla de especificación, que un slot Gen4 con dieciséis lanes carga lo que cargan ocho lanes Gen5. La mitad.
Pieza por debajo de la plataforma. Lo inverso cuesta menos y por eso ocurre más: plataforma Gen5 poblada con NVMe Gen4 o Gen3. El bus es actual, los discos no lo son, y la capa de almacenamiento anda en la generación de los discos. Capacidad y cantidad son idénticas en las tres generaciones, así que la cotización no revela nada.
En la práctica: generación del slot, generación del dispositivo y ancho en lanes son tres números separados. Trate a una cotización que da uno de los tres como si no hubiera dado ninguno.
10 · Las piezas que usted tiene permiso de comprar
Las nueve primeras se toman una vez y se vuelven física. La décima se toma una vez y gobierna toda compra posterior, incluidas las que arreglarían las otras nueve.
Existe una iniciativa formal de arquitectura abierta de servidor, el Open Compute Project, fundación neutral que publica diseños de hardware y los principios que un diseño necesita cumplir para llevar el nombre. La definición de apertura es explícita: la medida es la capacidad de un tercero de construir, modificar o personalizar el dispositivo a partir de la contribución. Es propiedad comprobable: o la plataforma cumple una definición publicada, o no la cumple.
En la práctica: las otras nueve se cotizan en la firma. Esta cotiza todo lo que venga después, porque decide si un disco de repuesto, un acelerador agregado o una ampliación de memoria sale a precio de mercado o a precio de catálogo.
La cuenta que cierra
Ahora la cuenta prometida en la apertura, abierta, con todas las premisas declaradas y reemplazables por las suyas.
Un rack, ocho nodos, horizonte de cinco años, carga limitada por ancho de banda de memoria, que es la premisa declarada de la cual todo lo de abajo depende. Dos especificaciones para el mismo trabajo. El sistema A es de generación corriente, doce canales a 1DPC y 6400, slots Gen5, discos de 3 DWPD, fuente Titanium y holgura térmica para la generación siguiente. El sistema B es de generación anterior, doce canales a 2DPC y 4400, slots Gen4, discos de 1 DWPD, fuente Gold y ninguna holgura.
Caudal de memoria, canales × tasa × 8 bytes

  A     12 canales × 6400        614 GB/s        100%
  B     12 canales × 4400        422 GB/s         69%

Para entregar el mismo trabajo que A, hacen falta 1,45 sistemas B.
Por lo tanto B tiene que ser 31% más barato SOLO PARA EMPATAR en caudal.

Y después de eso todavía pierde:

  electricidad      + US$ 22 mil por rack en cinco años (Gold contra Titanium)
  almacenamiento    + un cambio de disco en el año 3,2 (1 DWPD contra 3)
  actualización     la del año tres se vuelve recompra, por falta de holgura térmica
  expansión         a precio de catálogo, si la arquitectura es cerrada
Treinta y uno por ciento antes de todo lo demás. Y el número empeora rápido: si la capacidad se alcanza poblando la mitad de los canales con módulos más grandes, el caudal cae al 38% y el descuento necesario para empatar sube al 62%.
Dos salvedades honestas. La premisa de que la carga está limitada por ancho de banda de memoria es declarada, no medida, y en un escenario limitado por cálculo el efecto es menor. Y las diez decisiones no suman de forma simple: la 2, la 8 y la 9 son la misma compra vista tres veces, así que contarlas por separado triplica una sola diferencia, mientras que la 10 multiplica lo que las demás cuesten arreglar después.
Lo que la cuenta hace no es darle su número. Es decir qué pregunta hacerle a sus dos cotizaciones: ¿es la más barata lo bastante barata? La mayoría de las veces la respuesta es aritmética, y lleva una tarde.
Errores de especificación más comunes
1 · Dimensionar el gabinete para la placa del día. El envolvente de potencia y térmico creció con cada generación de acelerador. Un chasis sin holgura convierte la próxima actualización en la próxima compra, y el ahorro de la firma es el menor de los dos números.
2 · Comparar capacidad instalada en vez de canales poblados. Dos sistemas con la misma memoria total pueden diferir por un factor de dos y medio. El gigabyte es el número que aparece en la cotización y el que menos decide.
3 · Leer un SKU de zócalo único como descuento. Es expansión cerrada. El camino documentado es sustitución del procesador, y ese costo aparece en el año tres, no en la firma.
4 · Dimensionar NVMe por capacidad e ignorar la clase de endurance. Un disco de lectura intensiva bajo carga de checkpoint agota la garantía antes de que el schedule contable cierre. La conversión es aritmética y lleva una línea.
5 · Presumir que las piezas que compra hoy son las que comprará en el año tres. La apertura tiene definición publicada y programa de conformidad auditable. O la plataforma cumple, o no cumple, y la respuesta decide si toda reparación posterior se cotiza por el mercado o por un catálogo.
6 · Aceptar una cuenta de aceleradores sin lane budget ni generación. Ocho aceleradores dejan 32 lanes para toda la red y todo el almacenamiento, y un slot de generación anterior corta a la mitad lo que cada lane carga.
7 · Poner una placa pasiva en un chasis que no fue hecho para enfriarla. La placa no tiene ventilador. Si el chasis no fuerza aire a través de las aletas a la presión estática exigida, la placa estrangula, después degrada, y la falla es térmica y no de fabricación.
Lo que todavía no se sabe
Esta entrada declara sus lagunas en vez de llenarlas, y son cinco.
No establecimos un número publicado para el volumen diario de escritura de una carga de entrenamiento. Lo más cercano es un estudio de producción con más de ochenta y cinco mil checkpoints, que ofrece fórmula de dimensionamiento y no número: tasa de escritura igual a la cuenta de parámetros por catorce bytes, dividida por el intervalo de checkpoint. Es método que usted corre, no cifra que alguien publique.
No establecimos una reducción cuantificada de vida útil por operación fuera del envolvente térmico. El mecanismo de estrangulamiento está documentado, como se citó arriba. Cuánto le cuesta al activo a lo largo de años, no.
No establecimos documentación institucional de restricción de pieza de expansión por licencia o firmware, y marcamos lo que tenemos como observación, no como evidencia.
No establecimos estudio de costo total de propiedad comparando arquitectura abierta y propietaria con metodología declarada.
No establecimos la razón de costo de adquisición entre clases para ninguna de las diez decisiones, de analista, organismo de norma o fabricante alguno. Por eso la quinta columna del cuadro está en GB/s, años y kilovatio-hora, y no en dinero, y por eso la cuenta que cierra el texto usa su diferencia de precio como entrada, y no la nuestra.
Un cierre
La propuesta más barata no es la que cuesta menos. Es aquella cuyos costos están todos visibles en la firma.
Toda decisión de este texto es legítima. Existe carga para la cual un zócalo de generación anterior, un SKU de un zócalo y fuentes Gold son exactamente lo correcto, y pagar más sería desperdicio. Lo que separa una buena cotización de una cotización barata no es qué elecciones hace. Es si dice qué elecciones hizo, y por cuántos años espera estar en lo cierto.
Un sistema armado con las piezas compatibles más baratas puede entregarse, y va a funcionar el primer día. Si puede ser confiable por el horizonte contra el cual fue vendido es otra pregunta, respondida por otra disciplina, y esa respuesta se diseña antes de armarse.
Fuentes
- Publication 946 (2025), How To Depreciate Property irs.gov ↗ verificado el 22/08/2026
- IRM 1.35.6 Property and Equipment Accounting irs.gov ↗ verificado el 22/08/2026
- Hardware lifecycle, warranty, and retirement for AI data centers computelaw.blog ↗ verificado el 22/08/2026
- 4th Gen AMD EPYC Processor Architecture (white paper) amd.com ↗ verificado el 22/08/2026
- AMD EPYC 9005 Series Processor Datasheet amd.com ↗ verificado el 22/08/2026
- Understanding Intel Xeon Processors: Numbers and Nomenclature intel.com ↗ verificado el 22/08/2026
- Why 2 DIMMs Per Channel Will Matter Less in Servers servethehome.com ↗ verificado el 22/08/2026
- JESD218B.03 Solid State Drive (SSD) Requirements and Endurance Test Method jedec.org ↗ verificado el 22/08/2026
- Endurance of NVMe, SAS and SATA SSDs (white paper) snia.org ↗ verificado el 22/08/2026
- 80 PLUS efficiency levels by class and load (compilation of the certifier's tables) en.wikipedia.org ↗ verificado el 22/08/2026
- Thermal Guidelines for Data Processing Environments, 5th Edition (errata) ashrae.org ↗ verificado el 22/08/2026
- Electric Power Monthly, Table 5.3, Average Price of Electricity to Ultimate Customers eia.gov ↗ verificado el 22/08/2026
- Global Data Center Survey 2025 datacenter.uptimeinstitute.com ↗ verificado el 22/08/2026
- PEX89000 Series, Managed PCI Express 5.0 Switches docs.broadcom.com ↗ verificado el 22/08/2026
- PEX8613 Performance Metrics (application note) docs.broadcom.com ↗ verificado el 22/08/2026
- Green500 list, June 2026, energy efficiency ranking in GFLOPS per watt top500.org ↗ verificado el 22/08/2026
- Form 10-K for the fiscal year ended December 31, 2024, note on estimated useful lives of servers and networking equipment sec.gov ↗ verificado el 22/08/2026
- PCI Express 6.0 Specification, transfer rate per lane by generation pcisig.com ↗ verificado el 22/08/2026
- NVIDIA H100 PCIe GPU Product Brief, interface modes and thermal qualification nvidia.com ↗ verificado el 22/08/2026
- Planning a Data Center Deployment, airflow requirement per kilowatt docs.nvidia.com ↗ verificado el 22/08/2026
- Field Constants, definitions of SW and HW thermal slowdown docs.nvidia.com ↗ verificado el 22/08/2026
- Open Compute Project, tenets and definition of openness opencompute.org ↗ verificado el 22/08/2026
Los valores específicos por producto deben verificarse en la documentación del fabricante correspondiente a la fecha de especificación. Este documento no sustituye la hoja de datos del equipo.